用 Python 训练自己的语音识别系统,这波操作稳了
语音识别技术正在改变我们与设备交互的方式,从智能音箱到实时字幕,它无处不在。但你是否想过,自己动手训练一个语音识别系统?不仅能深入理解背后的原理,还能根据自己的需求定制模型。今天,我们就用 Python 一步步搭建并训练一个简单的语音识别系统,这波操作真的很稳。
1. 语音识别的基本流程
一个完整的语音识别系统通常包含以下步骤:
- 数据准备:收集音频和对应的文本标注。
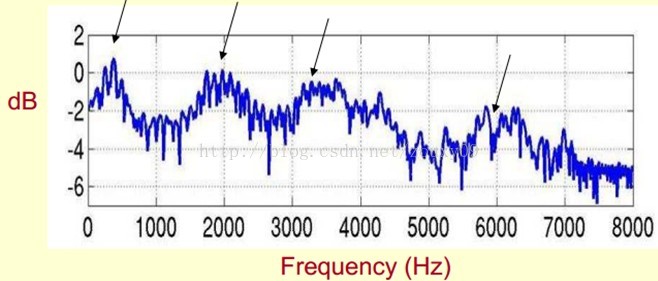
- 特征提取:将音频转换为声学特征(如 MFCC、梅尔频谱)。
- 模型构建:选择并搭建声学模型(如 CNN、RNN、Transformer)。
- 训练:使用数据训练模型,优化参数。
- 解码:将模型输出转换为最终文本(如 CTC 解码、Beam Search)。
- 评估:计算词错误率(WER)等指标。
2. 工具与环境
我们主要使用以下 Python 库:
- Librosa:音频加载与特征提取。
- PyTorch:深度学习框架,用于构建和训练模型。
- 音素或字符级标注工具:如 torchaudio、Hugging Face 的 datasets。
- CTC 损失:处理输入输出长度不一致的问题。
安装所需库:`bash
pip install torch torchaudio librosa numpy`
3. 数据准备
对于初学者,可以使用开源数据集,如 LibriSpeech、Common Voice 或 THCHS-30(中文)。每个样本包含一个 .wav 文件和对应的 .txt 文本。
`python
import librosa
import numpy as np
加载音频
audiopath = 'data/sample.wav'
signal, sr = librosa.load(audiopath, sr=16000)
# 提取 MFCC 特征
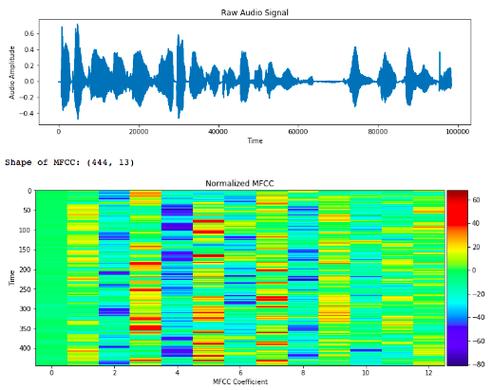
mfcc = librosa.feature.mfcc(y=signal, sr=sr, n_mfcc=13)
mfcc = mfcc.T # 形状 (时间步, 特征维度)
print(mfcc.shape)`
文本需要转换成字符或音素序列。例如,将句子 "hello" 转为 ['h','e','l','l','o']。
4. 构建声学模型(CTC + RNN)
CTC(Connectionist Temporal Classification)允许模型直接输出字符序列,无需严格对齐。我们用一个简单的双向 LSTM 作为示例。
`python
import torch
import torch.nn as nn
class ASRModel(nn.Module):
def init(self, inputdim, hiddendim, vocabsize):
super().init()
self.lstm = nn.LSTM(inputdim, hiddendim, numlayers=2,
bidirectional=True, batchfirst=True, dropout=0.3)
self.fc = nn.Linear(hiddendim * 2, vocab_size) # 双向
def forward(self, x):
# x: (batch, time, features)
out, = self.lstm(x)
logits = self.fc(out) # (batch, time, vocabsize)
return logits`
5. 训练循环
定义损失函数为 nn.CTCLoss,优化器用 Adam。
`python
model = ASRModel(inputdim=13, hiddendim=256, vocab_size=29) # 假设26字母+空格+for epoch in range(50):
model.train()
totalloss = 0
for batch in dataloader:
features, labels, inputlengths, labellengths = batch
optimizer.zerograd()
logits = model(features) # (batch, time, vocab)
logprobs = logits.logsoftmax(2) # CTC 需要 logsoftmax
loss = criterion(logprobs.transpose(0, 1), labels, inputlengths, labellengths)
loss.backward()
optimizer.step()
totalloss += loss.item()
print(f'Epoch {epoch+1}, Loss: {totalloss/len(dataloader)}')`
6. 解码与测试
训练完成后,用贪心解码将输出转为文本。
`python
import torch
def greedydecode(logprobs, idx2char):
# log_probs: (time, vocab)
indices = torch.argmax(log_probs, dim=1)
decoded = []
prev = None
for idx in indices:
idx = idx.item()
if idx != 0 and idx != prev: # 0 是 blank
decoded.append(idx2char[idx])
prev = idx
return ''.join(decoded)`
7. 实战经验与优化建议
- 数据增强:加入噪声、变速、音量扰动,提升泛化能力。
- 更先进的模型:尝试 Transformer、Conformer 或预训练模型(如 Wav2Vec2)。
- 使用迁移学习:基于 Hugging Face 的预训练模型微调,可大幅减少数据需求。
- 调参:学习率、批次大小、LSTM 层数等对结果影响显著。
- 解码优化:使用 Beam Search 或结合语言模型可显著降低 WER。
##
通过 Python 训练自己的语音识别系统,虽然入门有一定挑战,但过程充满乐趣,且能让你深刻理解 AI 如何“听懂”人类语言。只需掌握数据、模型、训练与解码四大环节,你就能打造属于你的语音识别应用。现在,不妨动手试试,这波操作稳了。
如若转载,请注明出处:http://www.dashuzn.com/product/34.html
更新时间:2026-10-15 07:23:06